

Se former à n8n pour automatiser vos workflows et prendre la main sur vos données
Un outil d’automatisation qui tourne en open source, qui se déploie aussi bien sur un serveur personnel que dans le cloud, et qui permet de connecter des dizaines d’applications sans écrire une seule ligne de code : n8n a progressivement attiré l’attention des équipes techniques comme des profils métier. Là où des outils comme Zapier ou Make imposent leurs contraintes tarifaires et leurs limites de personnalisation, n8n offre une liberté d’architecture que peu de plateformes comparables proposent. Apprendre à s’en servir demande cependant une approche structurée, car l’interface visuelle cache une logique de traitement des données qui mérite d’être comprise avant d’être exploitée.
Saisir la logique des nodes et du canvas
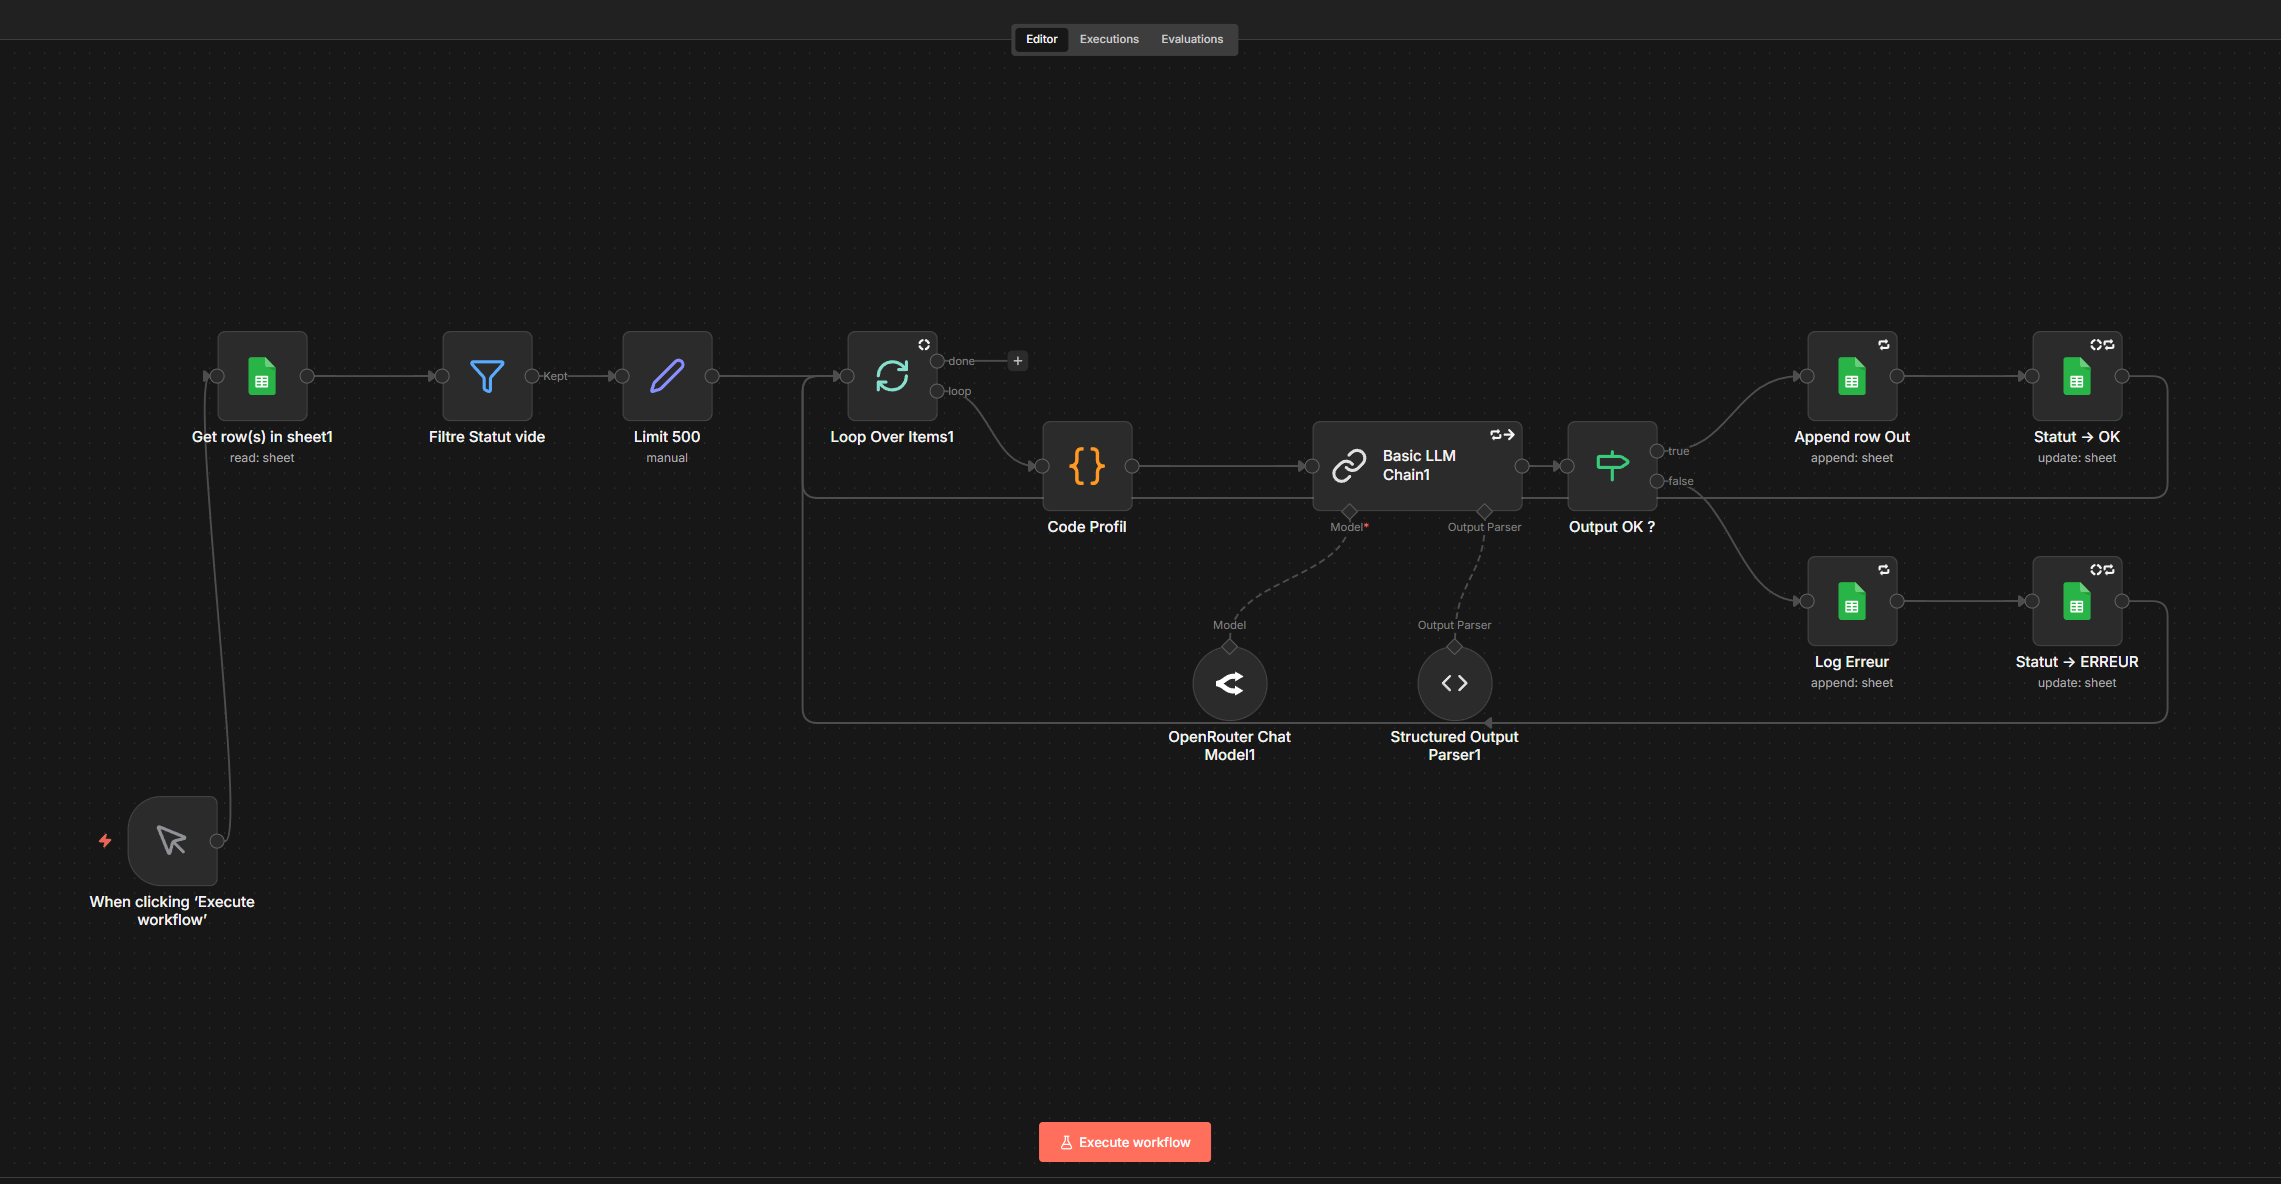
Avant de construire quoi que ce soit, il faut observer comment n8n organise visuellement un workflow. L’interface se présente comme un canvas blanc sur lequel on place des blocs appelés nodes. Chaque node représente soit un déclencheur (un formulaire soumis, un email reçu, une heure programmée), soit une action (envoyer un message Slack, créer une ligne dans un Google Sheet, appeler une API externe). Les nodes se relient entre eux par des fils qui matérialisent le chemin que suivent les données.
Cette représentation n’est pas qu’esthétique. Elle reflète une logique de traitement séquentielle : chaque node reçoit un objet JSON en entrée, le transforme ou l’enrichit, puis transmet le résultat au suivant. Comprendre ce flux de données dès le départ évite la majorité des erreurs que font les débutants, qui cherchent souvent à corriger un résultat sans avoir identifié à quel node le problème est apparu.
La première session de prise en main devrait donc se limiter à observer, pas à construire. Ouvrir un workflow existant, cliquer sur chaque node, lire ce qu’il reçoit et ce qu’il produit : c’est le meilleur moyen de comprendre la mécanique avant de s’y confronter. Pour ceux qui préfèrent un cadre guidé, apprendre à maitriser n8n via une formation structurée permet de brûler les étapes inutiles et d’entrer directement dans les cas d’usage professionnels.
Construire un premier workflow fonctionnel
Le premier workflow utile n’a pas besoin d’être sophistiqué. Un déclencheur webhook qui reçoit des données, un node qui les transforme, et un node final qui les envoie quelque part : cette séquence de trois blocs suffit à comprendre 80 % de la logique de n8n. Ce qui compte à ce stade, c’est de faire tourner quelque chose de réel, pas de simuler.
Un cas pratique accessible pour débuter : récupérer automatiquement les nouveaux abonnés d’un formulaire en ligne, filtrer ceux qui ont coché une case spécifique, puis les ajouter à une liste dans un outil CRM. Ce workflow ne dépasse pas quatre nodes, mais il oblige à manipuler les données, à tester les conditions, et à comprendre pourquoi un node peut recevoir zéro élément alors que le précédent en a traité dix.
L’exécution manuelle (via le bouton « Execute Workflow » dans l’interface) permet de voir en temps réel ce que chaque node produit. C’est une fonctionnalité à utiliser sans modération pendant la phase d’apprentissage : chaque exécution affiche les données entrantes et sortantes de chaque bloc, ce qui transforme le canvas en outil de débogage visuel.
Maîtriser la gestion des données et des expressions
La vraie difficulté de n8n n’est pas de connecter des outils, c’est de manipuler les données qu’ils échangent. N8n utilise un système d’expressions basé sur une syntaxe propre (proche du JavaScript) pour accéder aux valeurs produites par les nodes précédents. Écrire `{{ $json.email }}` pour récupérer le champ email d’un objet, ou `{{ $node[« HTTP Request »].json.data }}` pour cibler la réponse d’un node spécifique : ce sont des gestes techniques simples, mais qui demandent de comprendre comment les données sont structurées en JSON.
Plusieurs erreurs reviennent régulièrement chez les débutants. La première : supposer que tous les nodes retournent le même format de données, alors que chaque intégration a sa propre structure. La deuxième : ne pas anticiper les cas où un champ est absent ou null, ce qui fait planter le workflow en production sans message d’erreur explicite. La troisième : ignorer le node « Set » qui permet de restructurer proprement les données avant de les transmettre, et qui évite de passer des objets surchargés de champs inutiles d’un bout à l’autre du workflow.
Prendre le temps de lire la documentation des nodes utilisés, même brièvement, réduit de façon significative le temps passé à déboguer. N8n dispose d’un éditeur d’expressions intégré qui affiche en temps réel le résultat de ce qu’on écrit : c’est l’outil le plus sous-utilisé par les nouveaux apprenants.
Connecter des APIs et des webhooks externes
N8n prend toute sa valeur quand il sort des intégrations natives pour aller chercher des services via leurs APIs. Le node « HTTP Request » est probablement le plus polyvalent de toute la plateforme : il permet d’appeler n’importe quelle API REST, de configurer les headers d’authentification, de gérer les paramètres de requête, et de traiter la réponse comme n’importe quel autre objet JSON dans le workflow.
Se former à cette étape suppose de comprendre les bases des requêtes HTTP : la différence entre GET et POST, ce qu’est un header d’autorisation Bearer, comment structurer un body en JSON. Ce n’est pas du code à proprement parler, mais c’est une culture technique que n8n rend accessible progressivement, parce que l’interface visuelle force à nommer chaque paramètre explicitement plutôt que de l’écrire dans un script.
Les webhooks fonctionnent dans l’autre sens : au lieu que n8n appelle un service externe, c’est le service externe qui envoie des données à n8n dès qu’un événement se produit. Configurer un webhook Stripe pour déclencher un workflow à chaque nouveau paiement, ou un webhook GitHub pour automatiser une action à chaque push sur une branche : ces cas d’usage sont représentatifs de ce que font les équipes techniques avec n8n au quotidien.
Intégrer l’IA dans ses automatisations
Depuis que les APIs de modèles de langage sont devenues accessibles, n8n s’est imposé comme un outil d’orchestration pour les workflows IA. Le node natif pour OpenAI, les nodes pour Anthropic ou Mistral, et surtout le node « AI Agent » permettent de construire des automatisations qui ne se contentent pas de déplacer des données, mais qui les analysent, les résument, les classifient ou génèrent du contenu à partir d’elles.
Un workflow typique dans ce registre : recevoir un email entrant, extraire son contenu via un node, l’envoyer à un modèle de langage avec un prompt structuré, récupérer la réponse, puis router automatiquement l’email vers la bonne équipe selon la catégorie identifiée par le modèle. Ce type d’automatisation IA ne requiert aucune compétence en machine learning, seulement une bonne compréhension du flux de données et de la façon dont on formule un prompt dans un contexte programmatique.
La gestion des erreurs devient particulièrement importante à ce stade. Les appels à des APIs IA peuvent échouer pour des raisons de quota, de timeout ou de format de réponse inattendu. Configurer des branches d’erreur dans le workflow, utiliser le node « Error Trigger » pour être notifié en cas de problème, et tester les cas limites avant de passer en production : ce sont des réflexes que les formations avancées intègrent systématiquement dans leur programme.
Passer en production et maintenir ses workflows
Un workflow qui tourne en test n’est pas un workflow en production. La différence tient à plusieurs détails que les débutants sous-estiment : la gestion des credentials (ne jamais coder en dur un token d’API dans un node), la documentation interne du workflow via les notes attachées à chaque node, et la mise en place d’alertes quand un workflow s’arrête de façon inattendue.
N8n propose un système de versionnement des workflows et un historique d’exécution qui permet de rejouer manuellement une exécution échouée avec les mêmes données d’entrée. Cette fonctionnalité est précieuse en production : quand un service externe était temporairement indisponible et a fait rater dix exécutions, il suffit de les rejouer une fois le service rétabli sans avoir à attendre que les déclencheurs se reproduisent naturellement.
La montée en compétence sur n8n suit une courbe prévisible. Les premières semaines sont consacrées à comprendre la logique des nodes et des données. Le mois suivant, on commence à construire des workflows réels pour son propre métier. Passé ce cap, la question n’est plus de savoir comment utiliser l’outil, mais de savoir quels processus méritent d’être automatisés, ce qui est une question de stratégie autant que de technique. C’est précisément à ce stade que l’investissement dans une formation structurée rend son plein effet : non pas pour apprendre les gestes, mais pour éviter les architectures fragiles qui coûtent du temps à maintenir.
La montée en puissance de n8n s’inscrit dans un mouvement plus large de démocratisation de l’automatisation, où des outils autrefois réservés aux équipes d’ingénieurs deviennent accessibles à des profils marketing, opérations ou finance. Ce glissement redéfinit progressivement ce que signifie être compétent dans un métier : maîtriser ses outils ne suffit plus, il faut aussi savoir orchestrer les flux de données qui les relient.
